先做可信记录,再考虑更多智能功能。
先完成个人 MVP,暂不做账号、云同步、社交与付费,也不加入 RAG、Agent、自主工具调用或自主训练建议。训练计划和营养计算与 AI 解析明确分工。
一款移动端优先的健身与饮食记录工具。复用训练计划,解析文字与餐食照片,将模型输出变成可修改、可确认的记录。
PERSONAL MVP · 当前为受保护预览。可通过下方真实界面与评测记录了解产品;公开体验入口待确认。
产品定义 · AI 设计 · 评测与验收
2026.08 — 2026.09
持续迭代
移动端优先 · 本地记录 PWA
本人主导 · Claude Code / Codex 协作
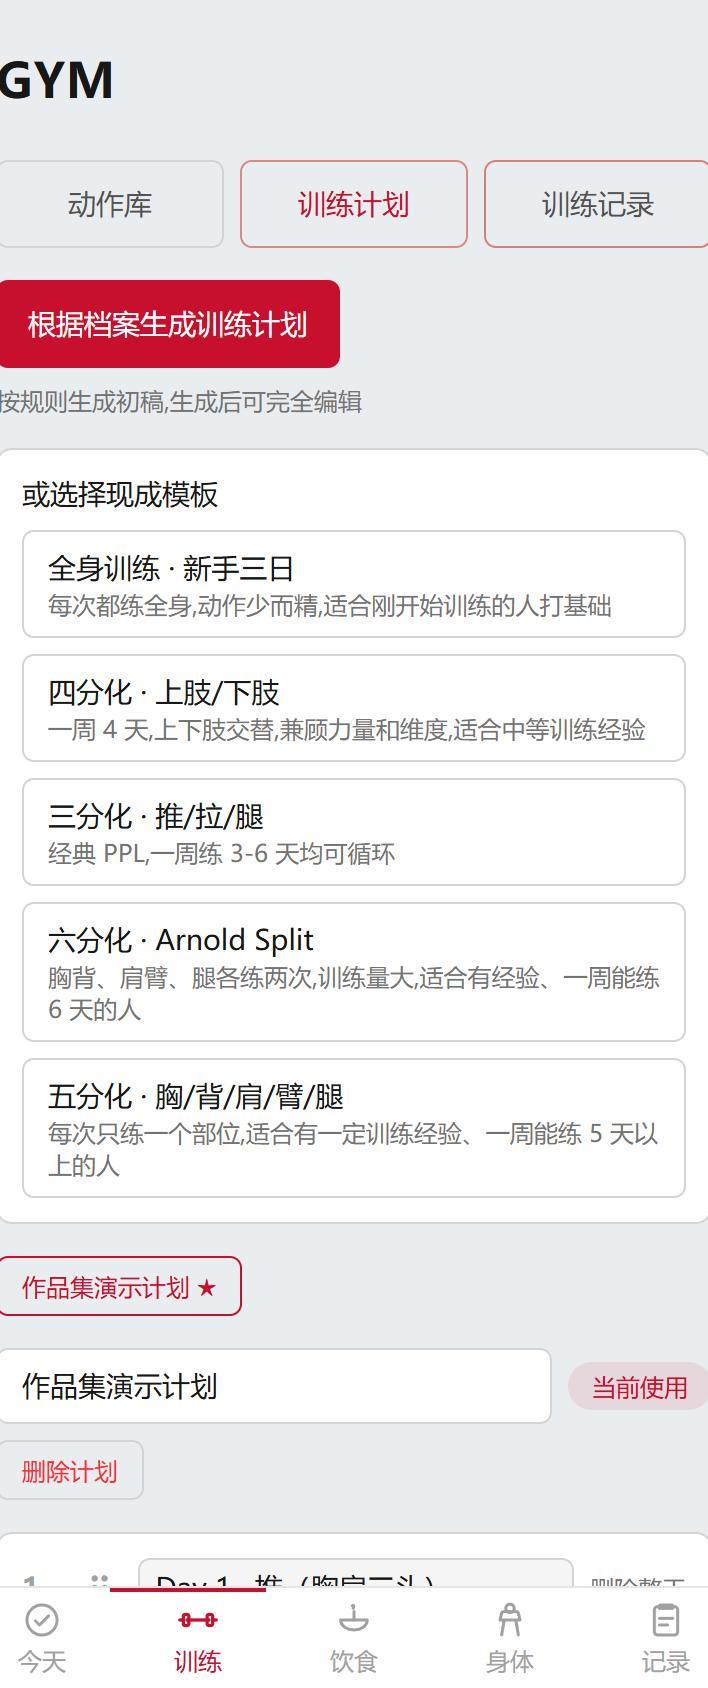
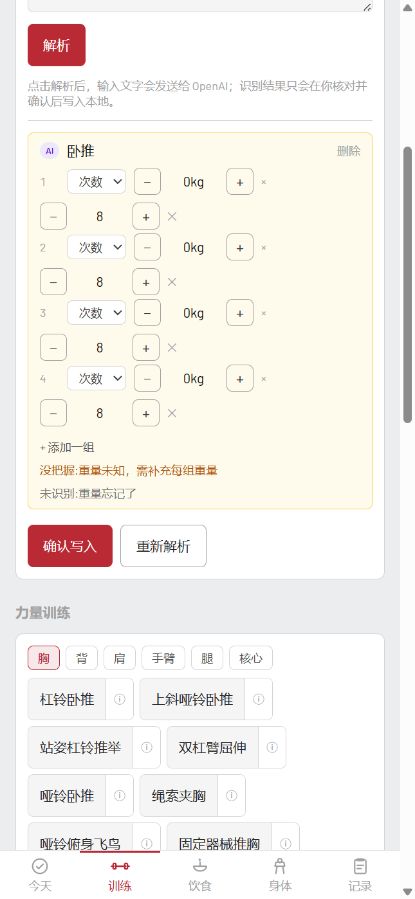
实际产品界面 · 合成演示数据 · 点击查看完整图片
AI 负责整理,用户保留最终决定权。
一分钟概览 / AT A GLANCE
直接查看证据 ↓训练中重复填写计划里已有的信息,补录时又容易把猜测写成事实。
常规记录优先复用计划;AI 只生成可编辑草稿,用户确认后写入。
20 条合成解析回归:边界 6/8 → 8/8;延迟中位数 5.29 → 6.41 秒。
个人场景与合成 API 测试;尚无真人编辑率、节省时间或留存证据。
产品推导 / CASE STUDY
01 / BACKGROUND & PROBLEM
项目来自我的健身经历。训练前要查今天的动作,训练中要回忆上次重量,训练后又要重新输入计划里已有的组数和动作。计划、短视频、备忘录与饮食记录分散,让一次训练不断被打断。
| 阶段 | 实际摩擦 | 产品机会 |
|---|---|---|
| 训练前 | 反复搜索计划与动作 | 把计划变成可执行入口 |
| 训练中 | 重复填写动作、组数和重量 | 导入计划并复用历史 |
| 训练后 | 饮食表达模糊,估算难检查 | 结构化候选结果,再人工确认 |
自然语言并非所有场景下更轻松。让用户重新描述已有计划,仍要组织语言、等待模型、检查结果,并承担调用成本。
目标用户假设是已经开始训练、尚未形成稳定计划和记录习惯的健身新手。JTBD 是快速确认今天的动作、要点与上次记录,用更少操作完成记录,把注意力留给训练。
该假设来自个人场景,尚无外部真人可用性测试、留存或节省时间的验证。不将个人使用经验表述为市场调研结论。
02 / PRODUCT STRATEGY
选择五种模板之一,或用本地规则生成计划;编辑训练日、动作、组数、目标范围与顺序。
导入当天训练日,复用目标日期之前的最近重量。力量和有氧都以未完成状态导入,不能把计划当成已经完成的训练。
逐组核对、修改并勾选次数或时长。只有实际完成的训练才进入完成判定,触发打卡与成长反馈。
临时训练、计划外动作与事后补录交给模型解析,结果先进入可编辑预览。常规重复训练使用点选、模板和预填,减少不必要的调用。
| 职责 | 处理方式 | 原因 |
|---|---|---|
| 指标、训练热量、食材比例 | 确定性公式与本地数据 | 稳定、可解释、可重复 |
| 训练计划初稿 | 本地规则与五种模板 | 不必每次请求模型 |
| 训练文字、饮食文字与照片 | OpenAI | 表达不统一,需要语义或视觉解析 |
| 餐食备注修正 | OpenAI + 可编辑预览 | 理解语义,但保留原记录控制 |
| 最终写入 | 用户确认 | 模型不能决定真实发生了什么 |
| 访问、限流与预算 | 代码 + Upstash | 费用控制不依赖模型判断 |
五种训练模板、52 个不重复动作名称(53 条分类记录)、动作要点与错误说明,支持训练中快速查看。饮食包含文字、照片、手动与本地食材搭配;克数修改后营养按比例联动。Today 提供月历、打卡与小熊猫反馈。
模板是产品化初稿,动作库并非完整专业教学视频库;本地食材搭配不是 AI 自动制定全天食谱。成长反馈已实现,但没有证据证明它提升留存。
先完成个人 MVP,暂不做账号、云同步、社交与付费,也不加入 RAG、Agent、自主工具调用或自主训练建议。训练计划和营养计算与 AI 解析明确分工。
03 / PHOTO → ESTIMATE → CONFIRM
照片输入识别食物并估算份量、热量与三大营养素;用户在可编辑预览中核对食材和重量,再确认写入。图片看不清的用油与份量,是必须保留人工修正的原因。
下方为 2026-09-06 基线运行 FP-01–FP-04 的模型输出。餐图是 AI 生成的合成测试素材;所有重量、kcal 与营养素都是模型估算,不是称重或实验室真值,也不能据此证明营养准确率。
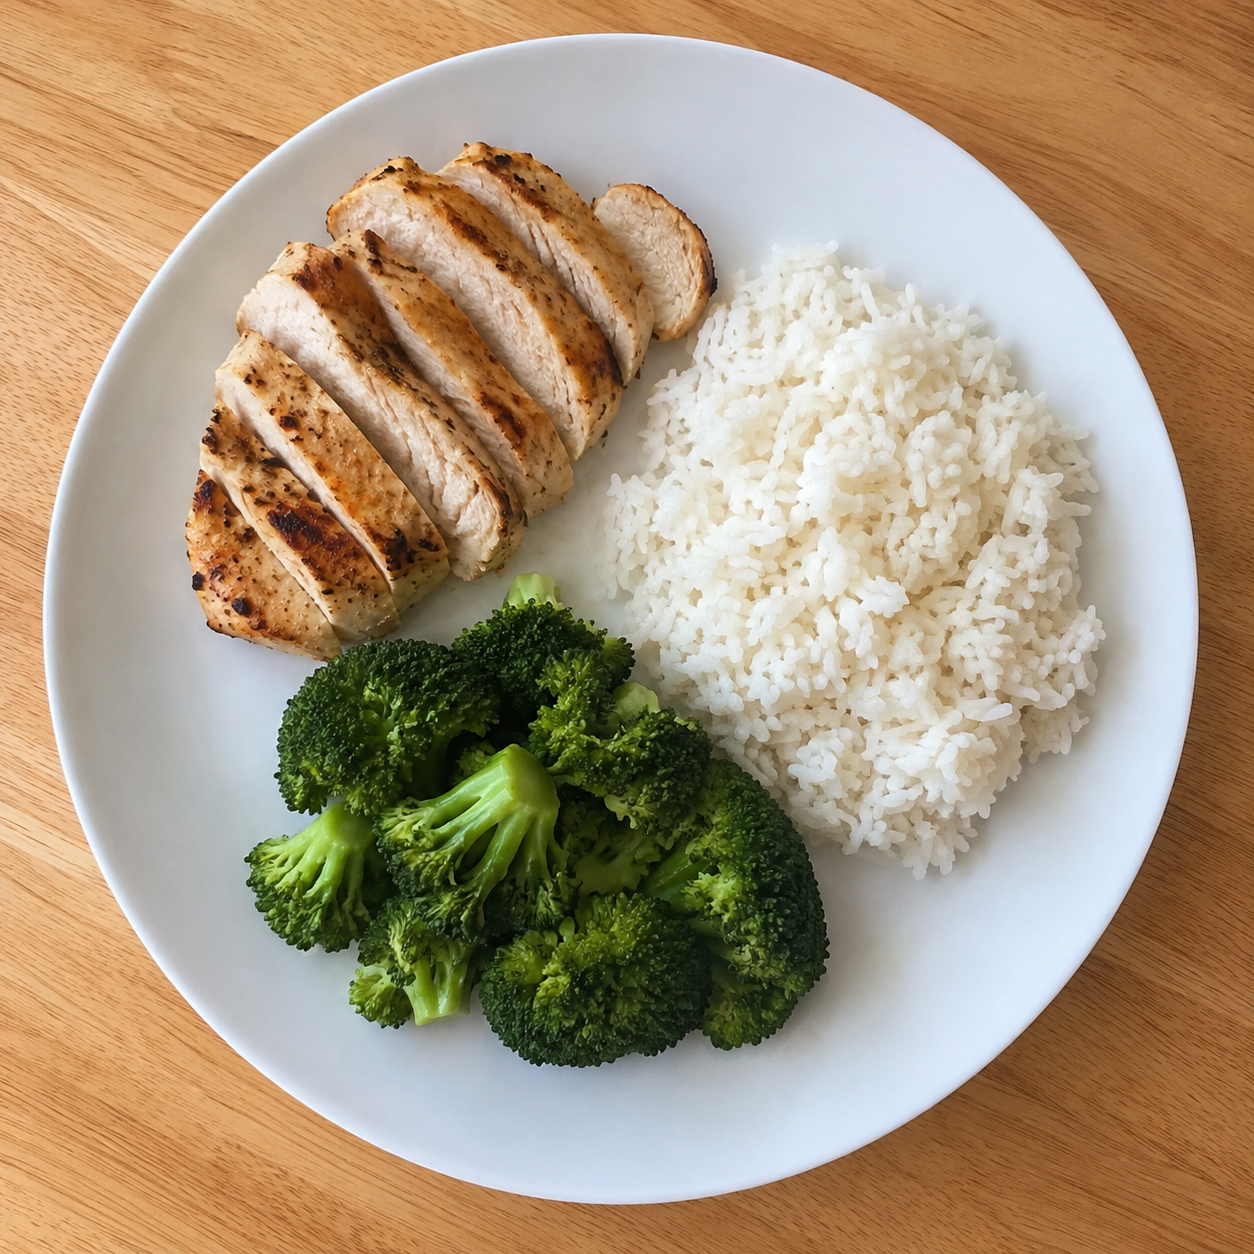
蛋白质 57.3g
碳水 64.6g · 脂肪 6.7g
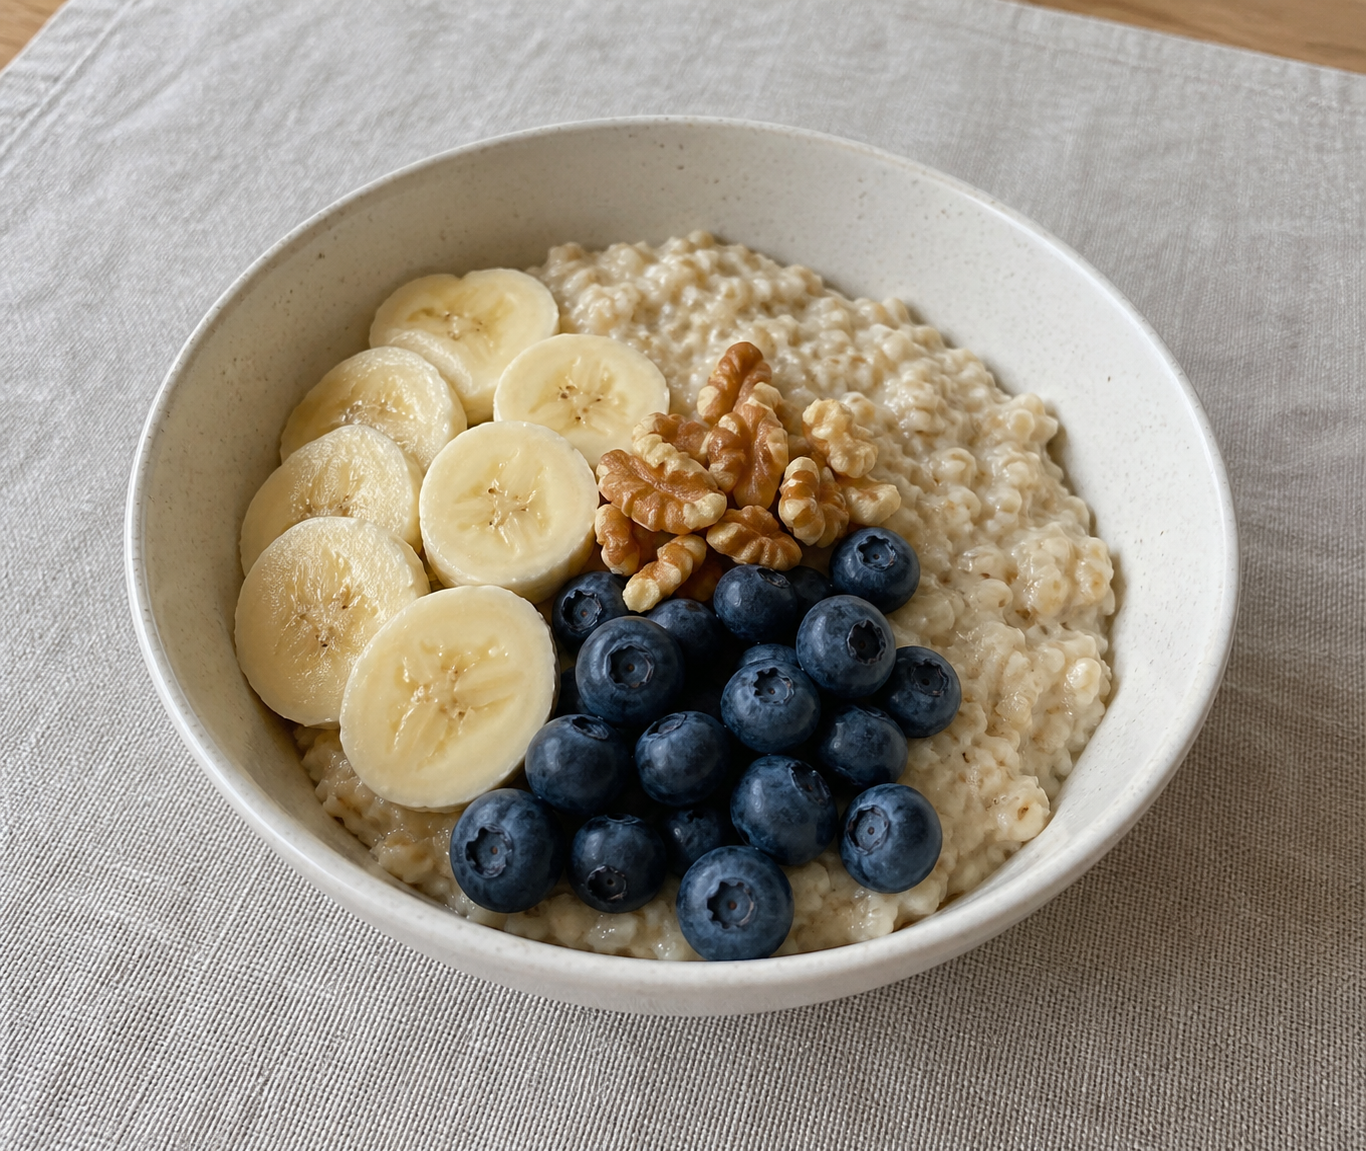
蛋白质 9.9g
碳水 59g · 脂肪 13.7g
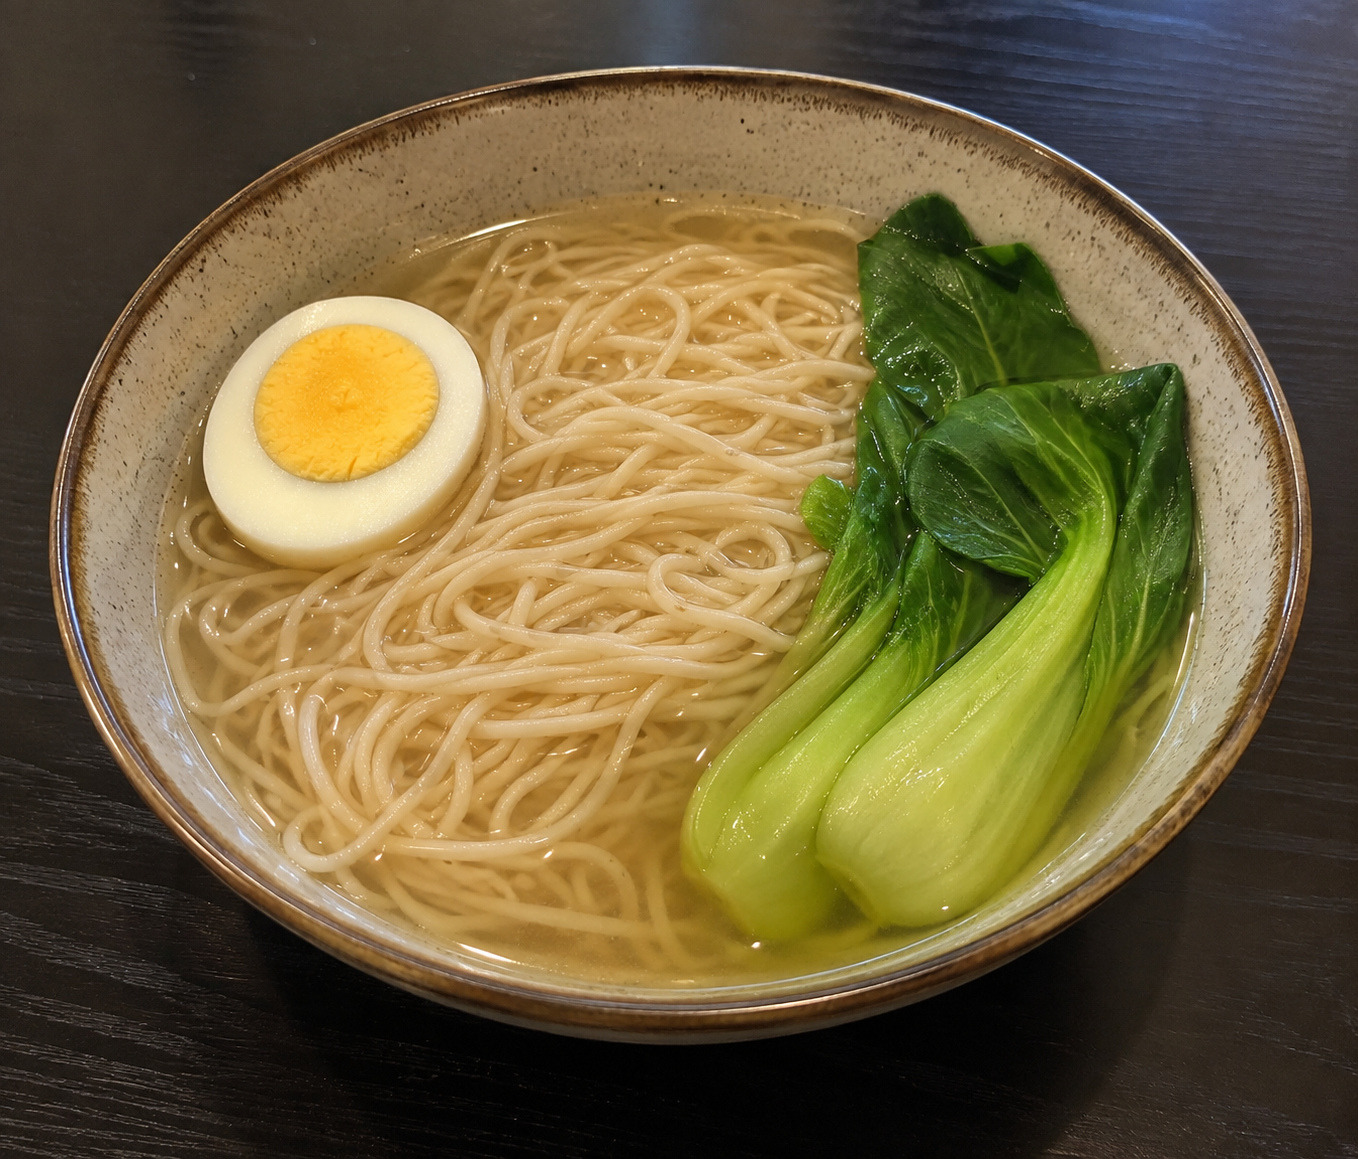
蛋白质 17.5g
碳水 69.9g · 脂肪 7.9g
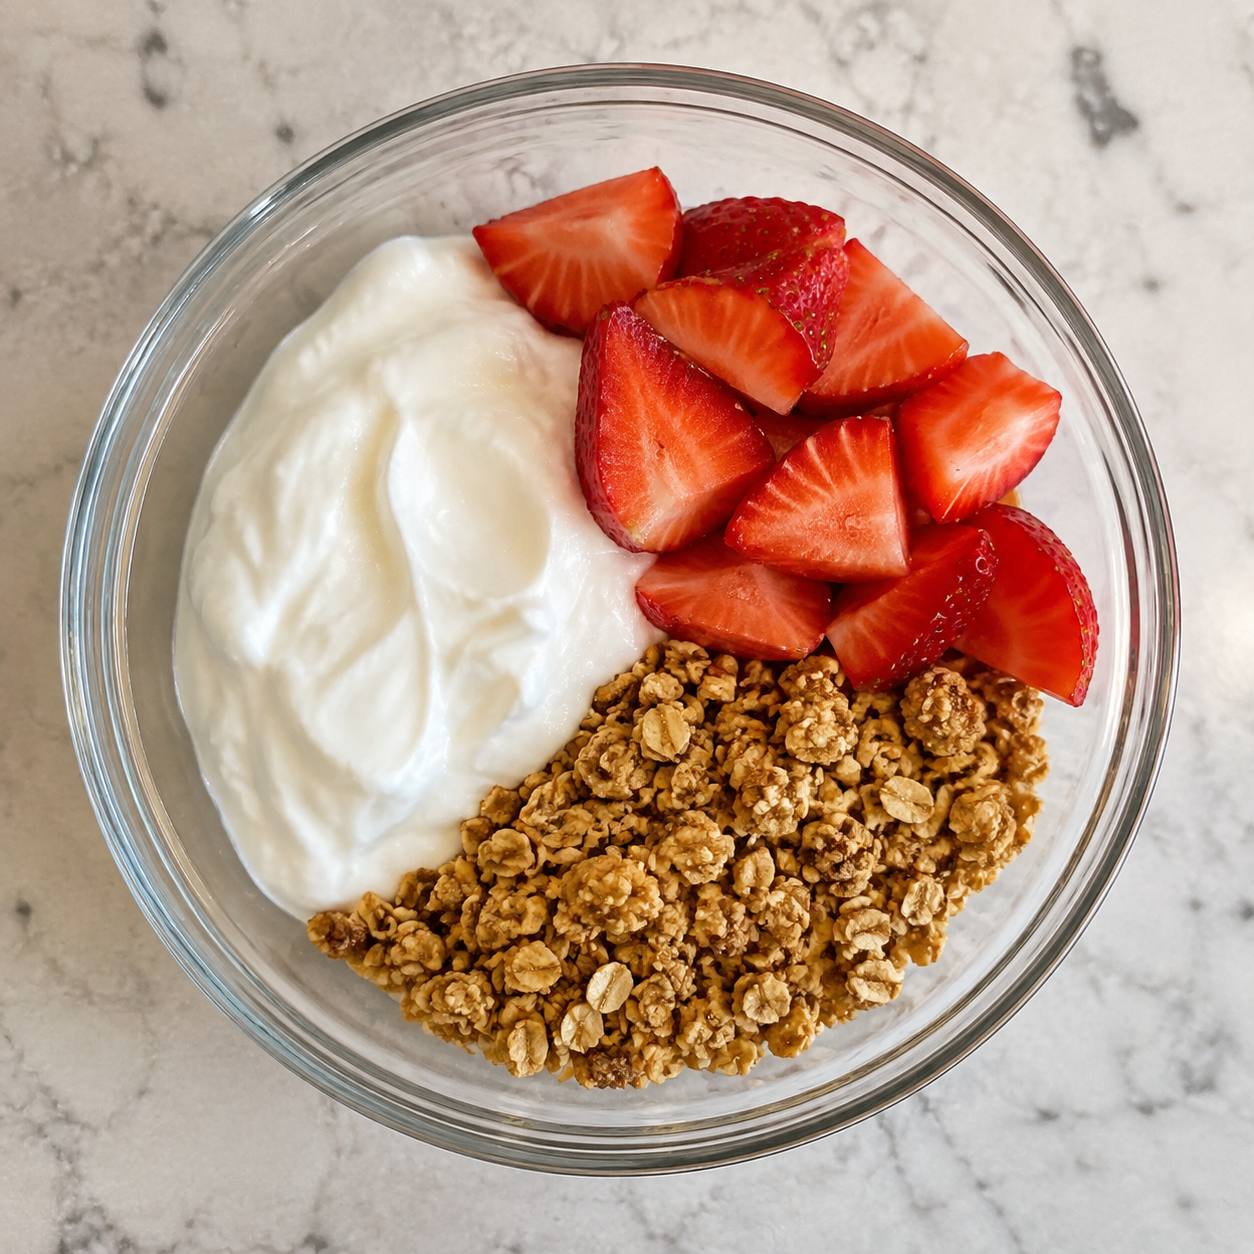
蛋白质 19.2g
碳水 41.9g · 脂肪 16.1g
| 识别食物 | 估算份量 | 热量 | 蛋白质 | 碳水 | 脂肪 |
|---|---|---|---|---|---|
| 烤鸡胸肉 | 160g | 264 kcal | 49.6g | 0g | 5.8g |
| 白米饭(熟) | 200g | 260 kcal | 4.8g | 56g | 0.4g |
| 西兰花(蒸) | 120g | 42 kcal | 2.9g | 8.6g | 0.5g |
此例按各食物输出相加为 566 kcal。展示逐项数据,方便用户修正份量或漏识别的食材,而不是只接受一个无法解释的总数。
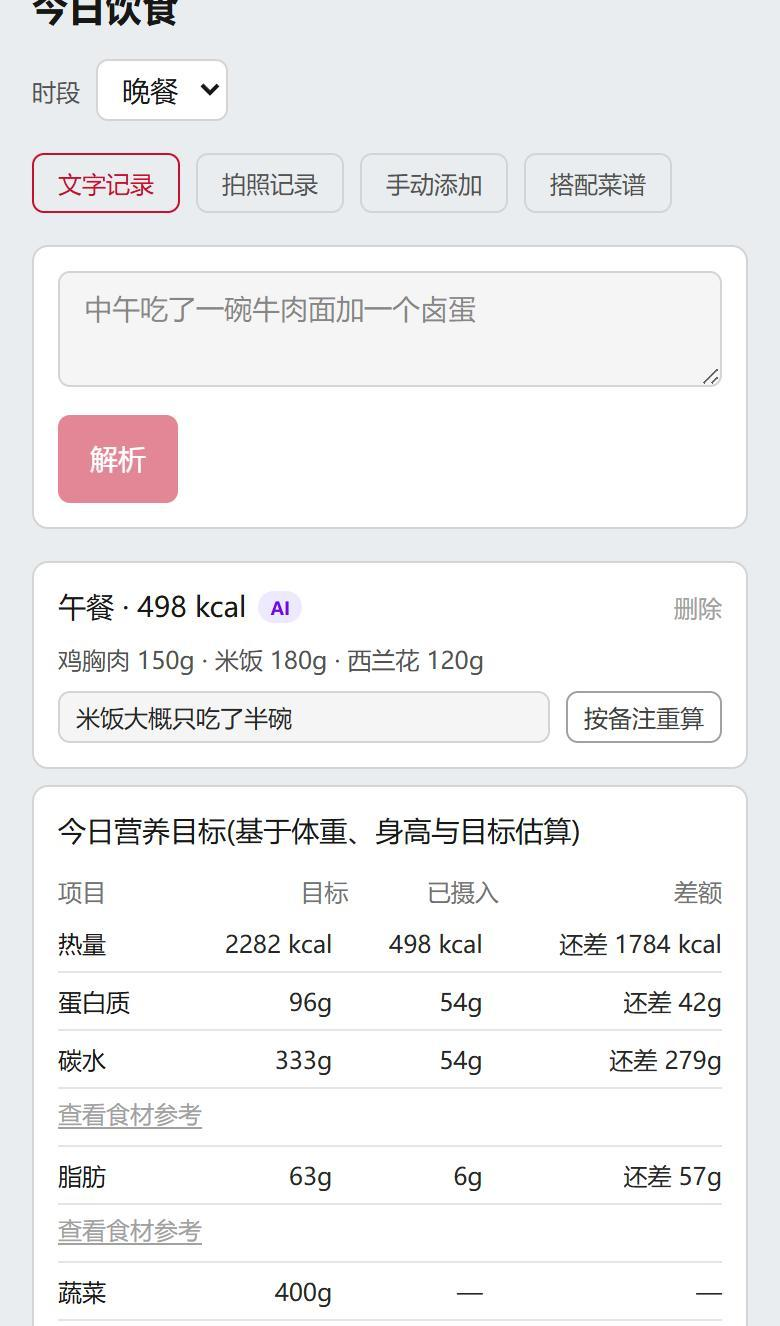
来自用户 PDF 第 11 页。图中 498 kcal 是既有演示记录,与上方 FP-01 的 566 kcal 不是同一次输出;此图展示保存后的界面,不作为照片识别过程证据。 · 点击放大
7 / 10 自动评分可直接确认
→10 / 10 复核同义词判分后可进入确认
范围为 10 条合成照片输入。人工复核修正了自动评分的同义词误判;这是既有输出复核,不是重新调用模型。可进入确认不等于营养值准确,更不是真人使用效果。
04 / AI ARCHITECTURE & HITL
当前使用 OpenAI Responses API,固定模型 gpt-5-mini-2025-08-07。四个接口分别处理训练文字、饮食文字、餐食照片与备注重算。原 Claude 请求在排除密钥注入问题后仍返回 403,因此迁移供应商,同时保留前端接口路径。
模型请求结束后,服务端按 usage 结算成本并记录脱敏审计;确认写入业务记录由用户单独控制。
Structured Outputs 之后仍保留双端校验。模型已返回可核实 Response、但 JSON 无法解析或结构不合法时,接口返回可审计的 422,区分于普通网络错误。
用户可编辑动作、重量、次数、时长与餐食营养。同名动作需要选择追加新组、替换已有组或返回编辑;重复导入可跳过同名动作或仍然追加。备注重算也先预览,取消后保留原始餐食。
模糊有氧时长不能直接变成可保存数字,缺少必要字段时阻止确认。未来计划不写成今日完成;AI 失败保留手动入口。训练批量写入先整体预检,再一次性保存,避免留下半条记录。
它可能代表自重,也可能是未知重量占位。系统会提示补充,但用户忽略提示后仍可能保存。下一步需要拆分自重与未知状态,将未知重量设为必须处理的阻断项。
业务记录默认保存在当前浏览器 LocalStorage,没有账号和多端同步。用户主动使用 AI 时,提交的文字或照片会发送给 OpenAI,入口提供说明;请求设置 store: false,不将此表述为全部数据都留在本地。
备份导入限制为 10MB,先校验结构与范围,覆盖前下载时间戳备份。损坏数据进入恢复页,可以导出原始数据;无效导入不覆盖已有记录。
React · TypeScript · Vite · Tailwind · PWA · Vercel Serverless · OpenAI Responses API · Upstash Redis · LocalStorage
05 / EVALUATION-DRIVEN ITERATION
冻结测试输入与 Rubric,区分 direct、partial、fail,关闭 SDK 自动重试;保留 Response ID、原始响应哈希、延迟、token 与估算成本。自动评分后逐条人工复核,修复使用新 Run ID,不覆盖历史基线。
| 输入 | 暴露的问题 | 修正 |
|---|---|---|
| 跑了一会儿 | 被写成虚构的 1 分钟 | minutes 允许 null 草稿,补信息后再保存 |
| 平板支撑三组,每组 30 秒 | 30 秒被写成 30 次 | 增加 durationSeconds,与 reps 严格二选一 |
| 重量忘了,四组每组八次 | 提示重量未知,却清空已知组次 | 保留 4×8 与待编辑重量;仍需解决 0kg 歧义 |
V1 至 V2 r4 的延迟中位数由 5290ms 增至 6405ms,约增加 21%。字段合约也发生变化,不能把差异全部归因于单次 Prompt 修改。当前结果证明已知合成用例的修复,尚缺未参与调优的独立测试集,以及真人对等待与修正成本的验证。
| 指标 | V1 | V2 r3 | V2 r4 |
|---|---|---|---|
| 核心题直接可用 | 12/12 | 12/12 | 12/12 |
| 核心字段 | 153/153 | 182/182 | 182/182 |
| 边界题 | 6/8 | 7/8 | 8/8 |
| 结构有效 | 20/20 | 20/20 | 20/20 |
| 延迟中位数 | 5290ms | 5327.5ms | 6405ms |
| Token | 22,574 | 31,629 | 33,482 |
| 估算成本 / 整轮 | $0.018317 | $0.019134 | $0.019038 |
V2 r4 从第一题完整重跑,其他 19 条无规则回归;动作名精确匹配 15/15,人工复核改分为 0。V2 r3 保留 20 个唯一 Response ID 和 20 个唯一响应哈希。
V1 与 V2 字段数量不同,不将字段分母直接当作同口径增幅。结果仅代表冻结合成数据与 Rubric 下的单轮记录,不是 20 位真人测试,也不是普遍的“AI 准确率 100%”。
35 次顺序调用:15 条饮食文字、10 条备注重算、10 张合成餐食图片。自动结果为 26 direct / 8 partial / 1 fail,人工复核后为 30 direct / 5 partial / 0 fail;其中 4 条是评分器未识别同义名称的误报。
| 检查项 | 35 条基线,人工复核后 | 仅 10 条重算回归 |
|---|---|---|
| 任务结果 | 30 direct / 5 partial / 0 fail | 10/10 direct |
| 结构有效 | 35/35 | 10/10 |
| 语义召回 | 100% | 100% |
| 语义精确率 | 98.7% | 100% |
| 硬检查 | 94.9% | 100% |
| 延迟中位数 | 10001ms | 9165ms |
| p95 | 20281ms | 14754ms |
| Token | 48,882 | 9,534 |
| 估算成本 / 整轮 | $0.058331 | $0.009828 |
真实问题包括备注未涉及的食物被修改、未修改食物的把握标签被抬高,以及营养已替换为脱脂牛奶但名称仍为全脂。修改重算 Prompt 后,只重跑 10 条重算用例,不将其写成 35 条全量回归。
语义指标按合成数据集评分口径计算,不代表营养识别达到医疗级准确度;high / mid / low 是模型自报把握标签,不是经过概率校准的置信度。
| 检查 | 已有结果 |
|---|---|
| AI Runtime Contract | 18/18 |
| API Guard | 10/10:方法、输入长度、伪造或截断图片等 |
| Public Demo Safety | 18/18 |
| Workout V2 评分器自检 | 47 项通过 |
| 离线验证 | 网络请求 0 |
| 项目构建 | Lint、TypeScript、Production Build 通过 |
另使用 8 个 AI-simulated personas、5 个关键任务进行 HITL 预测试,发现未知重量、批量修改和阻断型提示等问题。它用于产生改进假设,不是 8 位真人访谈,不能计算用户成功率、满意度或修正耗时。
本页引用项目提供的评测与复核记录;本次作品集更新没有重新运行付费模型评测。
06 / DELIVERY & REFLECTION
公开演示前,我将成本与失败处理纳入产品设计:共享访问码、Upstash 跨实例计数、预算预留与结算,以及不保存原始输入的脱敏审计。
每次请求预留 $0.025,结束后按 usage 结算;无 usage 的失败保守记账,达到 80% 预算触发一次提醒。Preview / Production 缺关键保护配置时拒绝调用,只有本地开发允许内存回退。
审计不记录原始文字、照片、IP、访问码或 API Key;图片先完整解码再重编码,不信任扩展名或浏览器声明的 MIME。
| 验收项 | 项目已有记录 |
|---|---|
| 无访问码 / 错误访问码 | HTTP 401 / 401 |
| 正确访问码 | HTTP 200,返回可编辑饮食结果 |
| 一次真实请求 | 538 token,估算 $0.000513 |
| Upstash 结算 | 请求计数 1;未释放预留 0 |
| 审计 | 1 条脱敏记录;Response ID 存在 |
| 客户端标识 | 24 位哈希 |
429 限流与 503 配置缺失保护已在固定测试中覆盖,未在线上修改配置注入故障,不能写为 Preview 实测。新版仍受 Vercel Preview 保护,正式 Production 晋升尚未完成;旧 Production 不包含全部新能力。
从个人问题定义、MVP 取舍、流程与数据合约,到 Prompt、人工确认、评测设计、复核、成本保护与部署验收,由我主导。代码实现通过 Claude Code 和 Codex 协作完成,不描述为独立手写全部代码或带领工程团队。
证据入口 / EVIDENCE
以下为已有项目记录的归档或节选。本轮核对文件与结论,未重新运行模型评测;原始运行、定向复测和用户验证分别说明。
固定模型、单次 parse-only 测试;不是用户保存成功率。
# Gym 训练解析正式回归结果 v2

- Run ID: `2026-09-06-openai-regression-v2-r4`
- 时间: 2026-09-06T07:01:47.324Z — 2026-09-06T07:04:08.599Z
- 产品快照: HEAD `5085274910049645212c70dca09ea35dc1a93e77`, dirty=true
- 数据集 SHA-256: `e90ce00eb894edb06d58dd736f0142ee8f3b34f3113f07b1d606d077009baa19`
- Prompt/source SHA-256: `8d6a87e2847e558a59955dda0e6f950dd0f05885e3f90acb116b12a39bbb4c43`
- 实际模型: `gpt-5-mini-2025-08-07`
- SDK 自动重试上限: 0;SDK 超时: 110000ms
- 环境: Node v24.16.0; win32 x64; local Vercel dev; Codex synthetic runner v2

## 汇总

- 核心题直接可用: 12/12 (100.0%)
- 核心题局部修正: 0/12 (0.0%)
- 核心题失败: 0/12 (0.0%)
- 核心字段准确率: 182/182 (100.0%)
- 边界处理通过: 8/8 (100.0%)
- 结构有效: 20/20 (100.0%)
- 延迟: 中位 6405ms,范围 3755–14421ms
- Token: input 24572,cached 21888,output 8910,reasoning 6400,total 33482
- 估算成本: $0.019038 USD(按运行时记录单价估算,非账单)
- Response ID: 20 条,唯一 20 条;唯一响应哈希 20 条
- 真人预览编辑率、修正耗时、最终保存一致性: NOT_MEASURED

## 逐题结果

| 用例 | 分组 | HTTP | 结构有效 | 判定 | 延迟ms | 规则判定说明 |
|---|---|---:|---|---|---:|---|
| WO-01 | core | 200 | 是 | direct | 14421 | 20/20 |
| WO-02 | core | 200 | 是 | direct | 6490 | 20/20 |
| WO-03 | core | 200 | 是 | direct | 6358 | 26/26 |
| WO-04 | core | 200 | 是 | direct | 4756 | 16/16 |
| WO-05 | core | 200 | 是 | direct | 4361 | 16/16 |
| WO-06 | core | 200 | 是 | direct | 5932 | 12/12 |
| WO-07 | core | 200 | 是 | direct | 5126 | 16/16 |
| WO-08 | core | 200 | 是 | direct | 6074 | 12/12 |
| WO-09 | core | 200 | 是 | direct | 6078 | 7/7 |
| WO-10 | core | 200 | 是 | direct | 7005 | 17/17 |
| WO-11 | core | 200 | 是 | direct | 6452 | 12/12 |
| WO-12 | core | 200 | 是 | direct | 4465 | 8/8 |
| WO-13 | boundary | 200 | 是 | pass | 6565 | 只保留4组8次卧推,使用0占位且在该条目明确提示重量缺失 |
| WO-14 | boundary | 200 | 是 | pass | 10613 | 只保留卧推动作但不造组,并在该条目提示组数/次数缺失 |
| WO-15 | boundary | 200 | 是 | pass | 5983 | 保留跑步,minutes为null且明确提示补充时长 |
| WO-16 | boundary | 200 | 是 | pass | 3755 | 休息语义返回空记录 |
| WO-17 | boundary | 200 | 是 | pass | 6690 | 更正后为4个次数组8/8/8/6 |
| WO-18 | boundary | 200 | 是 | pass | 9384 | 平板支撑正确保留为3个30秒计时组 |
| WO-19 | boundary | 200 | 是 | pass | 12042 | 返回空结果,或只保留4组8次卧推并在该条目明确提示重量单位缺失 |
| WO-20 | boundary | 200 | 是 | pass | 8327 | 返回空结果,或只保留4组未完成的卧推计划 |

## 解释边界

本轮为一次、合成、API parse-only 回归。评测器每题只发一个请求且不重试。它不代表外部用户表现、线上 SLA、真实保存流程或健康结果。原始接口响应保存在同名 JSON 的 `records[].raw_response_or_error`。
20 条自动判定未改分;仍保留自重提示与未知重量的解释边界。
# Gym 训练解析 V2 r4 正式回归人工复核

- Run ID:`2026-09-06-openai-regression-v2-r4`
- 复核范围:逐条阅读 20 条 `records[].raw_response_or_error`、结构化结果、自动判定理由与模型元数据,并与 r3 对照。
- 复核结论:20 条自动判定均符合既定 Rubric,人工改分 0 条;WO-13 修复生效,其他 19 条没有规则回归。
- 证据边界:这是 20 条合成输入的一次 API parse-only 回归,不是 20 位用户测试;预览编辑率、修正耗时和最终保存一致性仍为 `NOT_MEASURED`。

## 证据完整性

- 20/20 请求完成;评测器重试为 0,OpenAI SDK `maxRetries` 为 0。
- 20/20 响应均有 Response ID,且 20 个 Response ID 与 20 个原始响应哈希各自唯一。
- 请求模型与 20 条实际模型均为 `gpt-5-mini-2025-08-07`。
- 20/20 返回 HTTP 200,20/20 通过运行时结构校验;没有 fatal 或付费输出失败记录。
- 运行前后 Git HEAD 与冻结文件哈希一致,正式 JSON 标记 `verified_unchanged_through_completion: true`;完成后不存在 r4 partial。

## 逐条复核

| 用例 | 人工结论 | 复核摘要 |
|---|---|---|
| WO-01 | direct | 卧推 60kg、4×8、已完成,字段与组展开正确。 |
| WO-02 | direct | 卧推 60kg 的 8/8/8/6 四组被正确保留。 |
| WO-03 | direct | 深蹲 80kg 3×10 与卧推 50kg 2×8 正确拆成两个动作。 |
| WO-04 | direct | 12.5kg 小数重量和 3×12 正确。 |
| WO-05 | direct | 40×10、50×8、60×6 三组递增重量没有串组。 |
| WO-06 | direct | 大写 `KG` 被正确识别为 kg。 |
| WO-07 | direct | 100 斤按规则换算为 50kg。 |
| WO-08 | direct | 100 磅按规则换算为 45.36kg。 |
| WO-09 | direct | 跑步 30 分钟、5km、平均心率 140、中等强度正确。 |
| WO-10 | direct | 力量与低强度单车混合输入均正确解析。 |
| WO-11 | direct | 快走 15 分钟与跳绳 5 分钟被拆为两条且强度正确。 |
| WO-12 | direct | 腿举 100kg 的单组 12 次正确。 |
| WO-13 | pass | 保留卧推 4×8 和完成状态,四组使用 `weight: 0` 待编辑占位,并在同一动作提示补充实际重量。 |
| WO-14 | pass | 保留卧推动作、不制造空壳组,并同时提示组数与次数缺失。 |
| WO-15 | pass | 保留跑步,`minutes: null`,没有制造时长、距离或心率,并要求补充分钟数。 |
| WO-16 | pass | “休息、没有训练”返回两个空数组。 |
| WO-17 | pass | 更正语义生效,最终为 8/8/8/6。 |
| WO-18 | pass | 平板支撑为 3 个 30 秒计时组,没有把秒数写成次数;额外的缺重量提示不影响结构或 Rubric,但属于可减少的预览噪音。 |
| WO-19 | pass | 保留 4×8 和数值 60,同时明确标记重量单位未知,没有静默确认 kg。 |
| WO-20 | pass | 明日计划保留为 4×8,四组全部 `done: false`,没有冒充今日完成。 |

## 与 r3 的对照结论

- 核心题继续保持 12/12 direct、182/182 字段准确、15/15 动作名精确匹配。
- WO-13 从 `sets: []` 变为四个 `weight: 0, reps: 8, done: true` 的组,并保留重量缺失提示,判定由 fail 变为 pass。
- WO-14~20 继续通过;部分备注文字发生非结构性变化,没有改变规则结论。
- 边界通过率由 r3 的 7/8 提升到 r4 的 8/8。该结论只适用于冻结 Prompt、固定模型和本轮合成数据,不能推断真人编辑率或线上 SLA。

## 后续观察项

WO-18 对平板支撑增加了“未提到重量,已用0作为占位”的提示。`weight: 0` 本身符合自重/计时动作设计,提示不会导致错误保存,也不违反当前 Rubric,因此不改分;但真人测试时应观察它是否造成困惑,再决定是否为明确自重动作取消这类提示。
归档日期:2026.09.07。下载文件附来源位置与 SHA-256,便于比对;哈希说明文件对应关系,不构成独立验证。